SAM 3とは?
SAM 3(SAM3)は、画像や動画の中の物を見つけて領域を分けるMetaのモデルです。「赤い椅子」のような短い概念や視覚的な指示で対象を選びます。出力は対象のピクセルを示すマスクです。
Meta・SAM 3 ↗SAM 3
画像 → 2Dマスク
SAM 3D Objects
画像 + マスク → 3Dオブジェクト
精密な選択と立体の再構築は、それぞれ異なる目的に対応します。形状、テクスチャ、シーンの構成に取りかかる前に、適切な被写体を選びましょう。 詳しく見る SAM 3D.

SAM 3でできることは?
テキストプロンプト
「赤い椅子」などの被写体を指定して、該当するオブジェクトを探します。
視覚的プロンプト
点、矩形、画像の例を使って、選択する対象を指定します。
動画のセグメンテーション
研究モデルは、フレーム間での検出と追跡を組み合わせます。
制作の進め方を選ぶ
合成用の製品を切り抜く、透過画像を準備する、3Dにしたい被写体を選択する。エクスポート前に細部を確認しましょう。
SAM 3の仕組み
説明する、指し示す
テキストで概念を指定し、点やボックスで視覚的に指示します。
検出して領域を分ける
検出器が一致する対象とマスクを推定します。共通の視覚基盤が検出と動画内の追跡を支えます。
マスクを調整する
含める・除外する指示で対象を調整できます。研究モデルは動画のフレーム間で同じ物を追跡する機能も備えます。
研究モデルのアーキテクチャです。アプリで提供される動画機能、表現形式、ツールは異なる場合があります。 公式コード ↗
SAM 1・SAM 2.1・SAM 3の比較
SA-37・対話的画像セグメンテーション・平均mIoU・高いほど良好
データと指標
| モデル | 1 クリック | 3 クリック | 5 クリック |
|---|---|---|---|
| SAM 1 H | 58.5 | 77.0 | 82.1 |
| SAM 2.1 L | 66.4 | 80.3 | 84.3 |
| SAM 3 | 66.1 | 81.3 | 85.1 |
mIoU:予測マスクと正解マスクの平均IoU。3種類のクリック数を評価しています。線は観測値を結ぶもので、中間値の推定ではありません。
出典: Carion et al. · SAM 3 · Table 6 · arXiv v1 (2025) ↗
5クリックではSAM 3が85.1 mIoU、SAM 2.1 Lが84.3です。1クリックではSAM 2.1 Lが66.4、SAM 3が66.1で、わずかに前者が上回ります。差は操作条件によって変わります。
対話型セグメンテーションの速度
論文の評価条件で測定された表6の処理性能です。Studioの応答時間ではありません。
- SAM 1 H
- 41.0
- SAM 2.1 L
- 93.0
- SAM 3
- 43.5
動画:SA-Vでの追跡
動画フレームにおけるマスクと境界の品質。高いほど良好です。研究モデルの比較です。
- SAM 2.1 L
- 78.4
- SAM 3
- 84.4
結果の読み方
2025年の論文で評価されたバージョンの過去の比較です。2026年10月7日に確認しました。何を測定するかはデータセット、プロンプト、指標によって異なります。これらのスコアは、Segmentitの生成時間やすべての写真の品質を予測するものではありません。
研究から、次の作品へ。
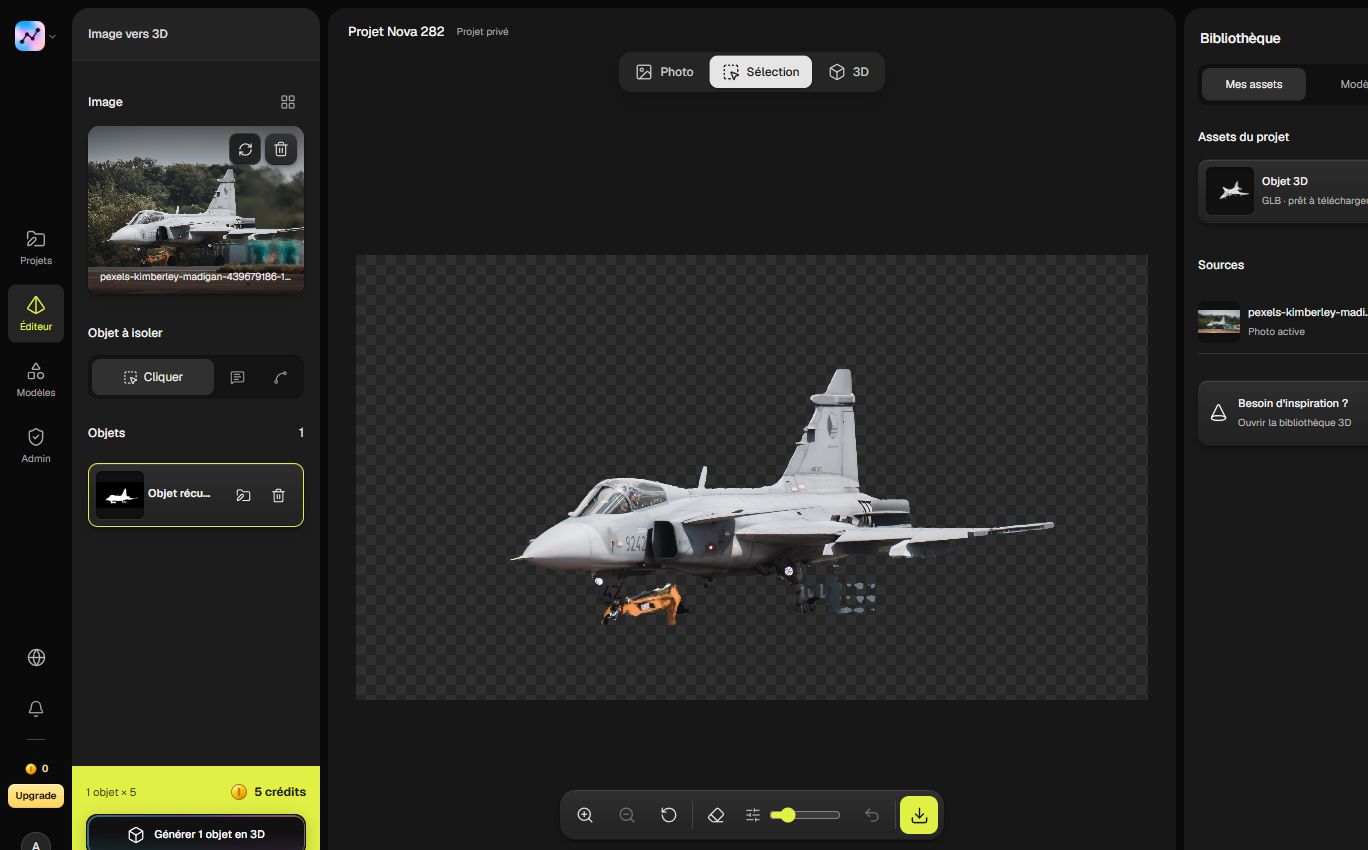
Segmentitでは、対象の選択が制作の第一歩です。輪郭を調整して透過PNGを保存するか、3D生成に進めます。明確なマスクで必要な物を残しましょう。
SAM 3についての質問
SAM 3は3Dモデルを作りますか?
SAM 3は領域を分けるマスクを作ります。3D再構成はSAM 3D Objectsが担当します。画像から3Dへの異なる工程を担うモデルです。
SAM 2から何が変わりましたか?
概念による指示で、テキストや例を使って対象を検索できます。上のグラフは別途、クリックによる対話的セグメンテーションを比較しています。
モデルはどこで入手できますか?
Metaは下記の公式SAM 3リポジトリでコード、重みへのアクセス方法、ノートブックを公開しています。画面で操作するにはSegmentit Studioを開いてください。
出典とドキュメント
確認日 · Segmentit編集部